性能监控与保护
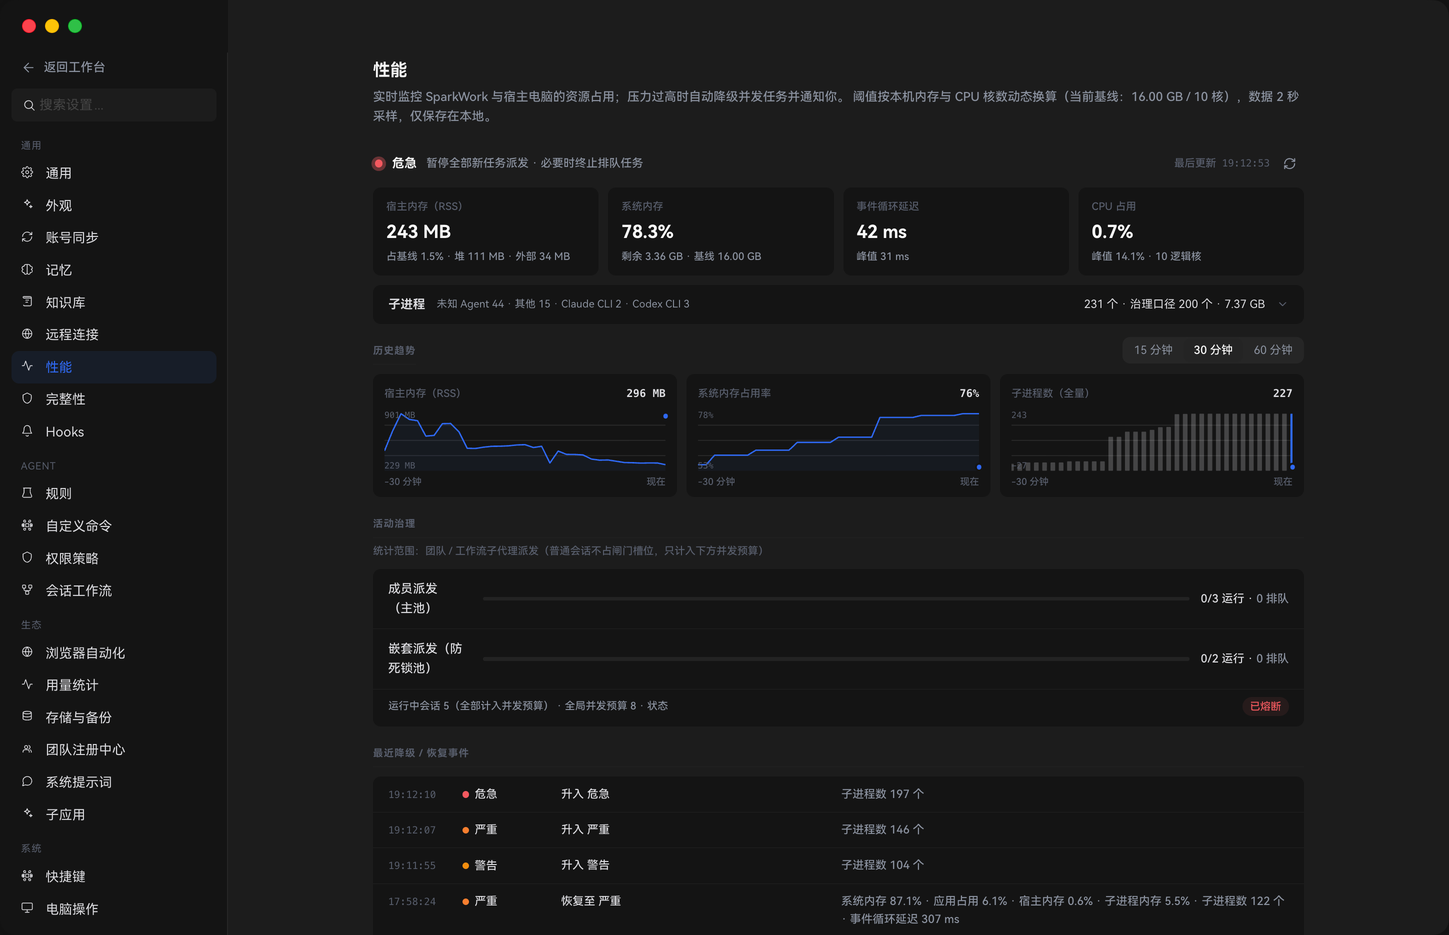
Spark Work 性能监控与保护完整指南:设置 → 系统 → 性能 的两个独立部分——资源监控(2 秒采样、六类判级指标、按宿主机内存与 CPU 核数换算的三档阈值、正常/警告/严重/危急四档与升级快降级慢的滞回、仅危急档打扰你、压力事件保留 7 天)与派发闸门(全局并发预算、宿主封顶、成员槽下限、成员并发硬顶、嵌套池配额与 15 秒逃生阀、主池 FIFO 与 120 秒超时)。讲清两层提示的区别(性能页内的档位提示条 vs 只在危急档出现的右上角消息弹窗 + 系统通知,含 2026-09-30 从顶部横幅改为消息弹窗的原因),并如实记录当前未接线的部分:压力级别已由装配层灌进闸门,但闸门内只记录档位,提示条文案描述的「按压力限流 / 暂停派发」尚不是真实行为,实际防护是固定的并发闸门加上危急档提醒。附性能页截图、两张架构图、可调项清单、五个区块导读、14 行排查表与 8 条常见问题。
长时间挂着多个 Agent 会话时,最容易出事的不是任务失败,而是整机被拖到失去响应:十几个 CLI 子进程同时醒来,内存被推到溢出边缘,鼠标都要等半秒。性能保护这套机制就是为此存在的,它分成两个互相独立的部分:
- 资源监控(观测与分级):2 秒采样宿主与应用资源,按三档阈值判出压力级别,落事件、推流、在紧急档打扰你。
- 派发闸门(真实生效的调控):所有后台子进程派发统一过一个双池并发闸门(主池 + 嵌套防死锁池),用「全局并发预算 + 成员并发硬顶」两个旋钮把并发物理收敛住。
入口在 设置 → 系统 → 性能。这一页讲清楚指标怎么采、阈值怎么算、级别怎么变、闸门怎么卡,以及哪些能力当前还没有接线——最后一点同样是事实,不写「看起来应该是这样」的描述。
先记住这四句话
- 阈值不写死绝对值:配置里只有百分比与系数,运行时按本机内存基线换算出 GB 等价值。
- 升级快、降级慢:warning/critical 要连续 2 个采样确认,降档要连续 6 个,且至少驻留 30 秒。
- 只有危急档才打扰你:warning / critical 静默记录(性能页可见),emergency 才弹右上角消息 + 一条系统通知。
- 真正防失控的第一道防线是并发闸门,阈值分级是第二道兜底。
1. 采样与数据落点
| 项 | 值 |
|---|---|
| 采样周期 | 2000 ms(sampleIntervalMs,可配范围 1000–300000) |
| 子进程批量采集 | nominal 态 10 s 一次;级别 ≥ warning 时每个采样周期都扫 |
| 进程树兜底扫描 | nominal 态 30 s 一次;活跃或加压时 10 s |
| 历史环形缓冲 | 30 分钟(historyWindowMinutes,可配 5–240) |
| 单次快照 pid 明细上限 | 64(maxTrackedChildren,可配 8–256,超限按 RSS 取 top) |
| 级别变更事件 | 落 SQLite 表 resource_pressure_events,保留 7 天(写入时顺带清理过期行) |
| 数据出网 | 不出网。性能页文案明确写着「数据 2 秒采样,仅保存在本地」 |
监控总开关 enabled = false 时不采样、不推送,应用行为与未接入监控完全一致——这是「关掉它就不该有副作用」的硬约束。
2. 监控哪些指标
判级指标一共六类,每类都有 warning / critical / emergency 三档:
| 指标 | 含义 | 单位 |
|---|---|---|
systemUsedPct | 系统内存占用率 | % |
appFootprintPct | 宿主 RSS + 治理口径子进程 RSS / 系统总内存 | % |
hostRssPct | 宿主主进程 RSS / 系统总内存 | % |
childrenRssPct | 治理口径子进程 RSS / 系统总内存 | % |
childrenCount | 治理口径子进程数(线程/进程爆炸代理指标) | 个数 |
eventLoopDelayMs | 事件循环延迟(EMA 平滑后的最大延迟) | ms |
整体级别取「各指标级别的最大值」(max-of-levels),而不是加权平均——任何一项越线都算越线。缺测指标(比如系统内存暂时读不到)按 nominal 计,但快照里保留 null,不会把它当 0 参与定级。
性能页的「资源总览」把其中四项做成常驻卡片:宿主内存(RSS)、系统内存、事件循环延迟、CPU 占用,每张卡都有副标题写明细节(占基线百分比、剩余内存、峰值、逻辑核数)。CPU 占用只做展示,不参与判级。
「子进程」是一张可展开的卡:折叠时显示总数 / 治理口径数 / 总 RSS 与按类型聚合的前四类;展开后按类型列出每个类别的个数与 RSS 占比明细。采集暂时失败时不会显示为零,而是标注「子进程采集暂时失败,以下为最近一次成功扫描结果」。
3. 阈值为什么不写死
这是这套机制最重要的设计约束:任何内存类阈值都不写死绝对值。配置与持久化里只有百分比(0–100 整数)与核数推导系数;运行时按宿主机规格基线 HostSpecBaseline(本机总内存 + CPU 核数)换算出展示用的绝对值并缓存,判定以百分比直比为准,字节数只用于展示与日志。
所以你能在性能页看到类似「阈值按本机内存与 CPU 核数动态换算(当前基线:…)」的说明——同一份默认配置在 16 GB 与 64 GB 机器上,换算出来的 GB 阈值完全不同。
唯一不做基线换算的是事件循环延迟:它是时间感知指标,直接以毫秒判定。
默认阈值表
| 指标 | warning | critical | emergency |
|---|---|---|---|
| 系统内存占用率 | 90% | 94% | 97% |
| 应用足迹(宿主 + 子进程) | 75% | 85% | 92% |
| 宿主进程 RSS | 45% | 60% | 75% |
| 子进程 RSS | 60% | 72% | 80% |
| 事件循环延迟 | 300 ms | 600 ms | 1200 ms |
| 子进程数 | 按核数与并发预算推导(见下) | — | — |
内存类 warning 之所以拉到 90% 这种「接近溢出」的位置,是 2026-09-23 的产品决策:常态使用不得触发压力提示。warning / critical 只是静默记录(性能页可见),通知只出现在 emergency。
子进程数阈值的 auto 推导
子进程数不是压力信号,它随「MCP 配置数 × 会话数」线性增长(每个会话光 MCP 常驻 node 载体就有十几个,满配 6 会话轻松上百),所以这个指标只做 fork 失控兜底,内存压力交给 childrenRssPct 承担。
mode: 'auto'(默认):warning = max(warnFloor, 核数 × warnMult, 并发预算 + warnOffset),三档系数默认8 / 12 / 16,floor 默认80 / 128 / 160,预算偏移默认0 / 8 / 16。floor 主导,核数乘数只用于防极低配误伤。mode: 'manual':高级用户可以给三档填绝对个数(范围 4–256)。
式子里那项 processBudget 直接复用并发闸门的 totalAgentProcessBudget,阈值会随闸门水涨船高,不会出现「闸门放宽了但阈值还卡在旧位置」的错配。
4. 级别怎么变(滞回)
级别枚举是 nominal → warning → critical → emergency 四档,界面上分别显示为正常 / 警告 / 严重 / 危急,升降不对称:
| 参数 | 默认值 | 作用 |
|---|---|---|
confirmSamplesToUpgrade | 2 | 升到 warning / critical 需连续 2 个采样确认 |
confirmSamplesToDowngrade | 6 | 降档需连续 6 个采样低于下沿 |
minDwellMs | 30000 | 级别变更后至少驻留 30 秒才允许降档 |
emergencyImmediateUpgrade | true | emergency 一轮立即升档,宁可误停不可溢出 |
而且降档一次只降一级——从 emergency 到 nominal 要经过 critical、warning 逐步回落。这套滞回的目的是不让级别在阈值边缘反复抖动,从而避免通知反复弹出。
5. 分级之后你会看到什么
| 级别 | 性能页展示 | 通知 |
|---|---|---|
nominal | 页头显示「资源充裕 · 正常调度」 | 从加压回落、完全恢复时补一条「电脑资源已恢复」 |
warning | 指标转警告色;活动治理区标「限流中」;页头提示条给出该档动作文案 | 不打扰 |
critical | 指标转严重色;活动治理区标「已暂停派发」 | 不打扰 |
emergency | 指标转危急色;活动治理区标「已熔断」 | 右上角消息弹窗 + 一条系统通知 |
这里有两层提示,别混:
- 性能页顶部的提示条:只在性能页内可见,非正常档一律显示该档动作文案(
限制新任务/暂停新派发/暂停全部新任务派发),右侧带「最后更新」与手动刷新。 - 应用级通知(
PressureNoticeHost):只有危急档才打扰你,右上角弹一条消息(带「查看性能」入口)加一条系统通知,压力降回危急以下即关弹窗。文案主语刻意是**「电脑资源压力」而不是「应用性能」**,并强调进行中的任务不受影响。系统通知失败就静默,不反过来影响监控。
2026-09-30 改造:危急提示从自绘的顶部常驻横幅改为统一消息弹窗(
useToast)。原因是那套横幅的样式只随懒加载的「设置」页 chunk 下发,冷启动后没进过设置页时样式缺失,横幅会退化成文档流里的普通块被排到窗口底部、压住会话输入区。
挂载前已发生的级别变更不会补发通知,否则每次切到性能页都会补弹一条过期提示。
6. 活动治理:真正卡住并发的闸门
「活动治理」区块展示的是 DispatchGovernor 的实时占用,它才是真正保护整机的部分。配置旋钮如下:
| 字段 | 默认值 | 范围 | 含义 |
|---|---|---|---|
enabled | true | — | 关闭时 acquire 立即放行,行为等同未挂闸门 |
totalAgentProcessBudget | 8 | 4–32 | 唯一权威预算。主池容量 = 预算 − 宿主会话有效计数 |
hostInflightCap | 5 | 3–6 | 宿主 inflight 会话计数以 min(inflight, cap) 计入主池,保证 6 会话满载时成员槽不被压穿 |
minMemberSlots | 3 | 1–4 | 成员槽下限:宿主计数最多压到 预算 − 该值 |
maxMemberDispatches | 6 | 1–32 | 成员并发硬顶 |
nestedDispatchSlots | 2 | 1–8 | 嵌套池(depth>0 派发 + 同步 peer call)独立配额,与主池隔离防死锁 |
deadlockEscapeAfterMs | 15000 | — | 嵌套池排队兜底放行时限,到时强制授予,防死锁等死 |
gateWaitTimeoutMs | 120000 | — | 主池 FIFO 排队超时,超时拒绝并给出可执行建议 |
几个关键语义:
- 一个 permit = 一次成员执行 = 至多一个 claude/codex CLI 子进程。 预算就是子进程数的物理上限。
- 实际主池准入容量 =
min(预算 − 宿主有效占用, maxMemberDispatches),宿主有效占用 =min(inflight, hostInflightCap, 预算 − minMemberSlots)。 - 容量收缩只影响新准入,不撤销在逃 permit——已经在跑的任务不会被中途掐掉,这一点很重要:保护机制不能让正在交付的任务半途死掉。
- 主池是 FIFO 排队,超时才拒绝;嵌套池有逃生阀,避免 A 等 B、B 等 A 死锁。
- 工作流的**波宽(
waveWidth,默认 4,可调 1–16)**是另一条独立约束,与闸门共同决定一次运行里同时推进多少节点。
性能页把主池与嵌套池的「在用 / 容量 / 等待数」两行占用直接画出来,并在降级时给状态标记——你能一眼看出「是并发满了在排队」还是「系统本来就闲着」。
7. 性能页的五个区块
| 区块 | 内容 |
|---|---|
| 资源总览 | 宿主内存 / 系统内存 / 事件循环延迟 / CPU 占用四张指标卡 + 可展开的子进程卡;带手动刷新 |
| 历史趋势 | 宿主内存、系统内存占用率、子进程数三条趋势,切 15 / 30 / 60 分钟窗口;前两条叠加 warning / critical / emergency 三条阈值线 |
| 活动治理 | 主池 + 嵌套池占用、宿主在途计数、按级别推导的降级状态标记 |
| 最近降级 / 恢复事件 | 从 resource_pressure_events 回看每次级别迁移:时间、升入还是恢复、越线指标与数值、阈值 |
| 性能保护 | 监控总开关、各项阈值、子进程数阈值模式、闸门配置,右上角有「恢复默认」 |
8. 可以调什么
「性能保护」区块里可调的项目:
- 监控开关:关掉即完全不采样(页面变成「性能监控未开启」的空态,带一个「开启性能监控」按钮)。
- 阈值三档数值:宿主内存 5–100%、系统内存 50–99%、事件循环 50–3000 ms(步长 50);内存类同时展示换算后的 GB 附注。
- 子进程数阈值:auto / manual 切换,manual 下填三档绝对个数(4–256,步长 2)。
- 闸门开关与预算:全局并发预算 4–32、成员并发硬顶 1–32。
- 工作流波宽:1–16。
- 恢复默认:一键回到本页默认值。
9. 当前还没有接线的地方(如实记录)
写在这里是因为界面文案与已实现行为存在差距,不说清会误导配置:
- 「按压力级别自动限流 / 暂停派发」目前只是预留。 级别确实被灌进了派发闸门——装配层已接线:
ResourceMonitorService的级别变更回调直接调governor.setPressureLevel,并且闸门晚于监控创建时会把当前档位补灌一次。但闸门内部这一步的注释仍是「M2 预留:本轮只记录档位」:setPressureLevel只存储档位与打日志,不参与准入判定。也就是说,提示条与配置面板里 warning 的「限制新任务」、critical 的「暂停新派发」、emergency 的「暂停全部新任务派发」这三句描述,当前并不是闸门的真实行为;真正在保护整机的是上面那套与压力级别无关的固定并发上限,以及危急档的弹窗提醒。 - 级别只在两处影响行为:危急档的右上角消息弹窗与系统通知;以及监控自身的采样密度(≥warning 时子进程扫描提到每周期一次)。
- 因此当前的实际防护顺序是:固定并发闸门(第一道)→ 压力分级与提醒(第二道,让你自己释放资源)。
如果你需要的是「压力高时自动拒绝新任务」,现阶段请直接调小 totalAgentProcessBudget 或 maxMemberDispatches——这是立刻生效、可验证的做法。
速查表
| 项目 | 内容 |
|---|---|
| 入口 | 设置 → 系统 → 性能 |
| 采样周期 | 2000 ms |
| 历史窗口 | 30 分钟 |
| 级别枚举 | nominal / warning / critical / emergency(界面显示为正常 / 警告 / 严重 / 危急) |
| 判级方式 | 各指标取最大级别(max-of-levels);缺测按 nominal |
| 判级指标 | 系统内存、应用足迹、宿主 RSS、子进程 RSS、子进程数、事件循环延迟(CPU 占用仅展示) |
| 默认紧急档 | 系统内存 97% / 应用足迹 92% / 宿主 RSS 75% / 子进程 RSS 80% / 事件循环 1200 ms |
| 滞回 | 升档确认 2 次(危急 1 次立即),降档确认 6 次,最短驻留 30 s |
| 性能页提示条 | 页面内可见,非正常档显示该档动作文案;不进通知 |
| 通知策略 | 仅危急档弹右上角消息弹窗 + 一条系统通知;完全恢复时补一条 |
| 事件保留 | resource_pressure_events 保留 7 天 |
| 闸门默认预算 | totalAgentProcessBudget = 8 |
| 宿主封顶 | hostInflightCap = 5 |
| 成员并发硬顶 | maxMemberDispatches = 6 |
| 嵌套池配额 | nestedDispatchSlots = 2 |
| 主池排队超时 | 120 s |
| 嵌套池逃生 | 15 s 后强制放行 |
| 数据是否出网 | 否,仅本地 |
排查表
| 现象 | 原因 | 怎么办 |
|---|---|---|
| 性能页显示「性能监控未开启」 | 监控总开关为关 | 点「开启性能监控」 |
| 指标卡显示 — 且标注采集失败 | 系统指标暂时读不到,会自动重试 | 稍等或点刷新;这不影响任务执行 |
| 子进程明细为空 | 还没开过 Agent 会话,没有子进程 | 打开一个会话后回来查看 |
| 明明很卡但没有提示 | 只有 emergency 才通知,warning/critical 静默 | 到性能页看「最近降级 / 恢复事件」与指标颜色 |
| 刚切到性能页没弹通知 | 挂载前发生的级别变更不补发 | 预期行为;看事件列表回溯 |
| 级别反复跳变 | 阈值贴得太近 | 拉开三档间距,或依赖默认滞回参数 |
| 换算出来的 GB 阈值和直觉不符 | 阈值是按本机内存基线换算的百分比 | 看页头「当前基线」说明;百分比才是判定依据 |
| 配了「警告档限流」,但压力高时任务照跑 | 压力 → 准入联动尚未接线 | 直接调小全局并发预算或成员并发硬顶 |
| 活动治理写着「已熔断」,任务却还在跑 | 该标记由当前压力级别推导,是状态呈现 | 预期行为;需要立刻限流就调小全局并发预算 |
| 危急时没看到顶部横幅 | 危急提示已于 2026-09-30 改为右上角消息弹窗 | 看右上角弹窗与系统通知;页头提示条仍在性能页内 |
| 任务一直排队不开始 | 主池容量满(预算被宿主占用压住) | 看活动治理的「在用 / 容量 / 等待数」;调大预算或减少并发会话 |
| 等很久后报排队超时 | 主池 FIFO 超过 gateWaitTimeoutMs(120 s) | 减少同时派发,或调大预算 |
| 嵌套派发被卡住 | 嵌套池配额被占满 | 等 15 s 逃生放行,或调大嵌套池配额 |
| 内存阈值改小了没生效 | 三档必须满足 warning ≤ critical ≤ emergency 才合理 | 按顺序调整,或点「恢复默认」重来 |
常见问题
这套机制会不会把正在跑的任务杀掉?
不会。闸门只控制新准入,容量收缩不撤销已经发出的 permit;已开始的任务会正常跑完。
为什么内存警告要等到 90% 才出现?
这是刻意的产品决策:常态使用不得触发压力提示。warning/critical 只是静默记录给性能页看,真正的通知只在临近溢出的紧急档出现。防失控的第一道防线是并发闸门,不是阈值告警。
为什么「子进程数」阈值这么大?
因为它是 fork 失控兜底,不是内存压力信号。每个会话的 MCP 常驻进程就十几个,满配 6 会话本就上百;把阈值设小会天天误报。内存压力由「子进程 RSS」指标承担。
阈值改了要不要重启应用?
不需要,「性能保护」区块里的改动会即时生效并回显;闸门配置变更也是热更新(已创建的闸门会 reconfigure)。
关掉监控能省性能吗?
能省掉采样本身的开销,但注意闸门是独立开关,关监控不会关闸门。两者要分别处理。
这些数据会上传吗?
不会。采样结果、趋势与压力事件都只保存在本地数据库,性能页文案与实现一致。
「活动治理」显示「已熔断」了,为什么我的任务还在跑?
因为那是状态呈现,不是已执行的限流动作。降级标记由当前压力级别推导而来,说明「现在在哪一档、按设计该做什么」;闸门目前并不按档位拒绝准入,真正让任务排队的是固定的并发上限。详见第 9 节。
性能页顶部的提示条和应用弹窗是一回事吗?
不是。页头提示条只在性能页内可见,非正常档一律显示该档的动作文案,用来解释「当前档位按设计会做什么」;应用级弹窗只在危急档出现,是唯一会主动打扰你的入口。所以「warning/critical 静默」指的是不打扰,不代表性能页上看不到。